
Líneas de investigación actuales
Aplicación de técnicas de inteligencia artificial en el análisis médico para la detección temprana de enfermedades y la optimización del diagnóstico clínico. Se emplearán modelos de aprendizaje profundo capaces de procesar imágenes médicas y datos biométricos con alta precisión. Estos modelos permitirán identificar patrones complejos entre síntomas y patologías. Asimismo, se integrarán modelos generativos de IA para la simulación y mejora de datos médicos. El objetivo es desarrollar un sistema inteligente que apoye la toma de decisiones médicas de forma predictiva y personalizada.
TRANSCRIPTÓMICA: Modelo variacional superficial para la generación realista de datos sintéticos de scRNA-seq
Resumen de nuestro proyecto
La secuenciación de ARN de célula única (scRNA-seq) permite analizar la heterogeneidad transcripcional con una resolución sin precedentes, constituyendo una herramienta clave para la investigación biomédica y, en particular, para el estudio de enfermedades neurológicas. No obstante, el análisis de este tipo de datos se ve limitado por la presencia de ruido, la alta esparsidad y el reducido tamaño de las muestras disponibles.
En este contexto, la generación de datos sintéticos realistas surge como una solución eficaz para proporcionar conjuntos de datos reproducibles que faciliten el desarrollo, la validación y la comparación de nuevos métodos computacionales. Sin embargo, muchos de los modelos generativos actuales basados en autoencoders variacionales asumen independencia entre las dimensiones latentes, lo que dificulta la captura de las dependencias gen-gen que caracterizan la estructura biológica real.
Para superar esta limitación, proponemos un modelo variacional superficial capaz de aprender una estructura de covarianza completa en el espacio latente, permitiendo representar interdependencias que reflejan relaciones de coexpresión y regulación génica. Este enfoque reproduce de forma fiel tanto los patrones marginales y multivariantes de expresión génica como la esparsidad característica de los datos scRNA-seq, proporcionando una herramienta robusta y realista para la generación de datos sintéticos en estudios de biología de sistemas y biomedicina.
CARDIOVASCULAR: IA Generativa para Bioseñales Cardíacas
Resumen de nuestro proyecto
Con el objetivo de detectar enfermedades cardiovasculares (ECV) de forma temprana, en los últimos años se
han desarrollado modelos basados en inteligencia artificial que, a partir del análisis de señales cardíacas
como los electrocardiogramas (ECG) o los fonocardiogramas (PCG), permiten realizar diagnósticos sobre
posibles patologías reflejadas en dichas señales.
MELANOMA: Deep Learning para la mejora del diagnóstico y la anticipación de inmunoterapias en melanoma
Resumen de nuestro proyecto
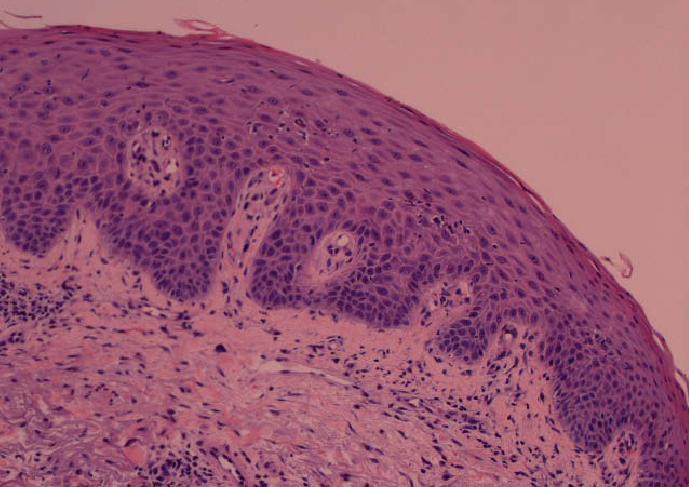
Desarrollo de modelos de Inteligencia Artificial basados en imágenes histopatológicas y datos clínicos para distinguir entre una lesión cutánea melanoma y una no melanoma y anticipar el comportamiento de los diferentes tratamientos inmunoterapéuticos que se pueden aplicar a cada paciente. Se propone el uso de modelos híbridos para poder hacer un diagnóstico entre nevus y melanoma y medir la eficacia de una terapia.
Convocatoria 2023 de ayudas UFV a Proyectos de Investigación.
Predicción y generación de datos sintéticos para el diagnósticos de diabetes gestacional
Resumen de nuestro proyecto
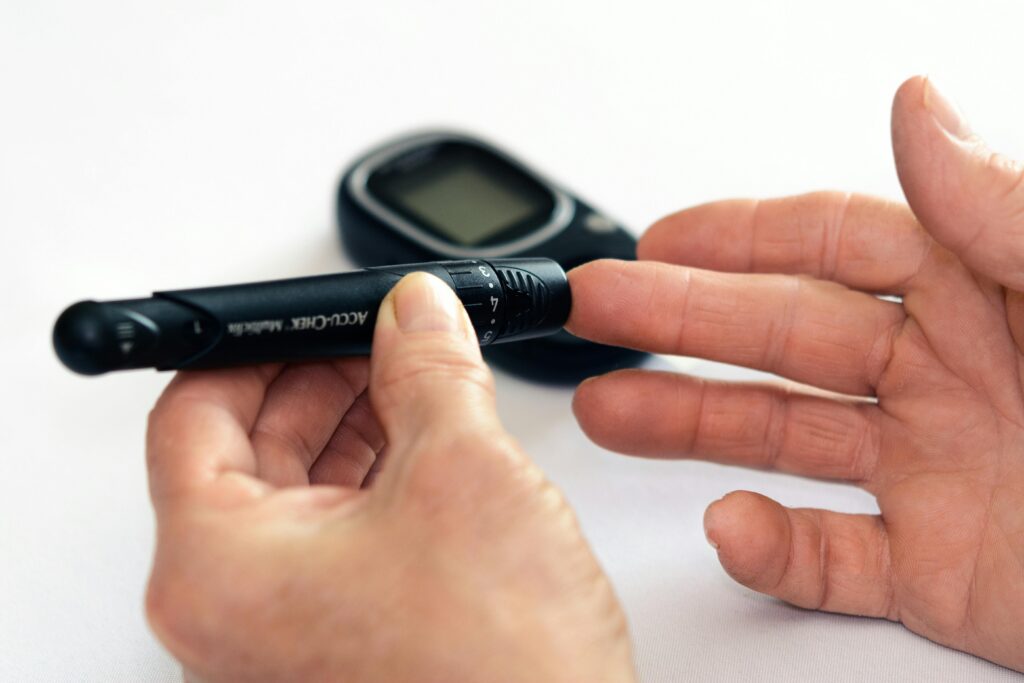
Esta línea de investigación aborda el estudio y desarrollo de modelos de aprendizaje automático para la detección temprana de diabetes gestacional. Para ello, se dispone de conjunto de muestras clínicas reales compuesto por variables numéricas relacionadas con el estado de salud de pacientes embarazadas (niveles de glucosa, edad gestacional, presión arterial, índice de masa corporal, parámetros hematológicos y otras métricas biomédicas relevantes), junto con su etiqueta diagnóstica.
Detección temprana de ELA mediante ecografía musculoesquelética e inteligencia artificial
Resumen de nuestro proyecto
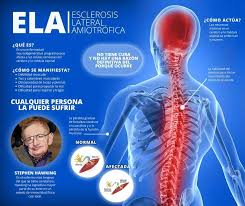
Línea de investigación centrada en el desarrollo de métodos de análisis automatizado para la detección precoz de ELA a través de imágenes ecográficas del tejido muscular y modelos de inteligencia artificial.
Se dispone de un conjunto de ecografías musculoesqueléticas adquiridas en cuatro músculos clínicamente relevantes para la progresión temprana de la enfermedad: bíceps braquial / braquial, flexores de muñeca, cuádriceps femoral y tibial anterior
En cada exploración se seleccionan Regiones de Interés (ROI) en áreas con máxima reflexión acústica para asegurar la mejor resolución diagnóstica y se evita tejido tendinoso intramuscular. Además de las imágenes brutas, se dispone de un conjunto de biomarcadores cuantitativos extraídos de los ROI
Análisis morfológico de glóbulos rojos mediante microscopía Thunder y visión por computador
Resumen de nuestro proyecto
Este proyecto, se desarrolla en colaboración con el grupo de Biofísica de la UFV, y se centra en la investigación de alteraciones morfológicas y estructurales en glóbulos rojos utilizando vídeos obtenidos mediante microscopía avanzada Thunder. Esta tecnología permite la adquisición de información tridimensional con gran resolución espacial, facilitando la exploración detallada de estructuras celulares en investigación biomolecular.
El objetivo principal es desarrollar un pipeline computacional para analizar automáticamente las variaciones en la membrana eritrocitaria, estudiando su geometría, deformabilidad y patrones estructurales
Desarrollo de modelos avanzados de inteligencia artificial mediante redes neuronales profundas, arquitecturas, CNN, GAN y Trasformes para la toma autónoma de decisiones en entornos complejos
TECT-CI5G: Tecnologías Transformadoras en Ciberseguridad: Aprendizaje Profundo y Minería de Grafos para la Inteligencia en Tráfico de Red 5G.
Resumen de nuestro proyecto
Uso de técnicas de IA y minería de datos en el desarrollo de aplicaciones de seguridad cibernética mediante la caracterización del tráfico de red y la detección de amenazas, por medio de un sistema robusto de análisis que garantice resultados precisos. Para ello se llevará a cabo la clasificación en tiempo real del tráfico en entornos 5G a través de la modelización de estas redes como grafos; la introducción de técnicas de análisis de grafos por medio de modelo de DL para detectar patrones recursivos de amenazas y por último la implementación de un sistema de defensa preventivo con modelos generativos de IA.
Convocatoria 2023 de Proyectos de Colaboración Público-Privada, Ministerio de Ciencia, Innovación y Universidades y Fondo Europeo de Desarrollo Regional (FEDER) (2024-2027). Financiación: 451.422 €
ESTRELLAS DE NEUTRONES: Descubriendo su interior mediante PINNs
Resumen de nuestro proyecto
Este proyecto desarrolla una prueba de concepto destinada a evaluar la capacidad de las Physics-Informed Neural Networks (PINNs) para resolver problemas inversos gobernados por ecuaciones diferenciales en presencia de ruido complejo. El objetivo estratégico es establecer una base metodológica que permita, en etapas posteriores, aplicar este enfoque a sistemas cuánticos abiertos, donde el ruido intrínseco y las limitaciones de medida dificultan la estimación de dinámicas y parámetros.
Como entorno de validación, el proyecto se centra en un sistema astrofísico con datos públicos y modelos físicos bien establecidos: la inferencia de la ecuación de estado de estrellas de neutrones mediante las ecuaciones de Tolman–Oppenheimer–Volkoff (TOV).
La prueba de concepto se centra en desarrollar modelos PINN que integren de forma explícita las ecuaciones físicas en la función de pérdida, utilizando observaciones ruidosas como datos de entrada. En el caso de las estrellas de neutrones, se analizará la capacidad del modelo para recuperar una ecuación de estado compatible tanto con los datos observacionales como con las restricciones impuestas por las ecuaciones TOV. De forma transversal, el proyecto estudiará cómo la naturaleza del ruido, las técnicas de regularización y las distintas estrategias de imposición física afectan a la estabilidad y precisión de las soluciones generadas por las PINNs. Los resultados permitirán determinar la viabilidad de este enfoque en escenarios donde la física del sistema está bien descrita pero los datos presentan ruido significativo, y servirán como base para extender la metodología a la dinámica cuántica ruidosa en proyectos futuros.
Convocatoria 2025 de ayudas UFV a Proyectos de Investigación.
Pulsa en el nodo central para ver las publicaciones
2026
Robustness of analogue Hawking radiation in cavities with moving boundaries
Resumen (ES)
⚠️[REVISAR: falta el abstract en español]
Abstract (EN)
In this work we explore the limitations and robustness of thermal radiation in dynamical Casimir systems serving as analogues for Hawking radiation. Through detailed numerical analysis, we characterize particle production spectra in cavities with moving boundaries under various configurations. We establish a thermality criterion based on the detailed balance condition, and we find that thermal signatures emerge in the spectrum of specific expanding cavity configurations, although they are highly dependent on frequency bands and acceleration parameters. Furthermore, our framework successfully verifies previous theoretical predictions, demonstrating that non-standard statistical distributions (such as Fermi–Dirac) can be robustly reproduced in finite confined settings despite the underlying field being purely bosonic. Further, we derive fitting expressions that quantify deviations from idealized thermal spectra through grey-body factors, revealing oscillatory behaviours tied to acceleration duration. Our results identify experimental setups that can reliably reproduce the thermal production akin to that from gravitationally-induced phenomena and quantify how finite-size effects and transient dynamics modify the expected thermal distributions, providing a comprehensive framework for distinguishing genuine Hawking-like radiation from experimental artefacts.
Evaluating the detection of small brain lesions in magnetic resonance using deep learning
Resumen (ES)
⚠️[REVISAR: falta el abstract en español]
Abstract (EN)
Introduction – Detecting brain lesions using Artificial Intelligence methods has been a focus of prior research, with numerous datasets supporting this task to improve clinical results. However, evaluation metrics and reported results often summarise overall performance without considering variations in lesion size. In clinical practice, the detection of small tumours is particularly critical for early diagnosis and treatment effectiveness.
Methods – This study evaluates the performance of Artificial Intelligence models on established datasets with a specific focus on lesion identification and lesion size. We introduce a novel Deep Learning model tailored to detect small brain tumours in Magnetic Resonance Imaging, integrating a clinically defined “small tumour” concept into both the training and evaluation processes.
Results – The proposed approach demonstrates robust performance, achieving loss values ranging from 1.5 to 11.1 and Dice Scores between 96.3% and 98.1% across multiple datasets.
Discussion – The main contribution of this work is the incorporation of clinically meaningful lesion-size information into model development and assessment. These findings suggest that explicitly considering small tumours can improve the clinical relevance of Artificial Intelligence systems for brain lesion detection and support earlier diagnosis and more effective treatment planning.
Lightweight hybrid spatiotemporal deep learning models for video frame prediction: A comparative study across dataset complexities
Resumen (ES)
En los últimos años, los avances en Inteligencia Artificial han impactado significativamente la visión por computadora, permitiendo soluciones para tareas complejas como la predicción de fotogramas de video. Esta tarea tiene aplicaciones críticas en dominios como los vehículos autónomos, la predicción meteorológica y la compresión de video. Si bien el Aprendizaje Profundo ha demostrado ser eficaz en el modelado espaciotemporal, las arquitecturas actuales a menudo presentan compromisos entre la precisión de la predicción y la eficiencia computacional. Para abordar este desafío, este estudio evalúa modelos híbridos ligeros de aprendizaje profundo que operan a nivel de mapa de características, utilizando autoencoders para la codificación espacial y el modelado de secuencias temporales a través de Memoria a Largo y Corto Plazo Convolucional (ConvLSTM), Redes Neuronales Convolucionales 3D (3D CNN) y arquitecturas temporales relacionadas. Las soluciones propuestas se prueban en términos de rendimiento, latencia y consumo de energía en tres conjuntos de datos de complejidad variable, que abarcan escenas sintéticas y del mundo real, así como imágenes en escala de grises y en color. Los resultados muestran que las arquitecturas basadas en 3D CNN y ConvLSTM superan a otros enfoques en conjuntos de datos del mundo real de baja complejidad. Además, los modelos propuestos reducen significativamente el tiempo de inferencia y el consumo de energía, ventajas clave para su implementación práctica en escenarios como la transmisión de vídeo o los sistemas de visión embebidos.
Abstract (EN)
In recent years, advances in Artificial Intelligence have significantly impacted computer vision, enabling solutions to complex tasks such as video frame prediction. This task has critical applications in domains like autonomous cars, weather forecasting, and video compression. While Deep Learning has proven effective in spatiotemporal modeling, current architectures often face trade-offs between prediction accuracy and computational efficiency. To address this challenge, this study evaluates lightweight hybrid deep learning models that operate at the feature-map level, using autoencoders for spatial encoding and temporal sequence modeling through Convolutional Long Short-Term Memory (ConvLSTM), 3D Convolutional Neural Networks (3D CNNs), and related temporal architectures. The proposed solutions are tested in terms of performance, latency and energy consumption on three datasets of varying complexity, encompassing synthetic and real-world scenes, as well as grayscale and color imagery. Results show that architectures based on 3D CNNs and ConvLSTMs outperform other approaches on low-complexity real-world datasets. Moreover, the proposed models significantly reduce inference time and energy consumption, key advantages for practical deployment in scenarios such as video streaming or embedded vision systems.
Leer el paper completo (se abre en una pestaña nueva) Ver en ScienceDirect (se abre en una pestaña nueva)
Deep learning for human activity recognition: A comprehensive review of architectures, performance, and challenges across five sensory datasets
Resumen (ES)
El reconocimiento de la actividad humana (HAR) mediante datos de sensores permite la detección automática del comportamiento y las acciones humanas en entornos cotidianos. El desarrollo de sistemas HAR escalables y que preserven la privacidad está respaldado por la recopilación no intrusiva de datos de series temporales utilizando dispositivos portátiles y sensores de teléfonos inteligentes. Los avances en el aprendizaje profundo han mejorado aún más la precisión del reconocimiento, ampliando las aplicaciones de HAR en todos los dominios, incluida la atención médica y la interacción persona-computadora. A diferencia de las encuestas existentes que se centran principalmente en los avances arquitectónicos, este estudio ofrece la primera revisión sistemática que coloca los conjuntos de datos de referencia en primer plano. Este estudio proporciona un examen exhaustivo de varios modelos profundos utilizados en HAR, evaluando sus ventajas relativas, limitaciones y estrategias de optimización basándose en una revisión exhaustiva de 226 estudios. También profundiza en los aspectos centrales del diseño del sistema HAR, incluido el preprocesamiento de datos, la extracción de características, las métricas de evaluación y los enfoques de validación. A través de un examen sistemático de 160 estudios, analizamos sistemas HAR construidos utilizando modelos profundos en términos de arquitectura, rendimiento y desafíos de implementación en cinco conjuntos de datos de referencia ampliamente adoptados (USC-HAD, PAMAP2, WISDM, UCI-HAR y OPPORTUNITY). Para garantizar una comparación equilibrada entre los puntos de referencia, analizamos 32 estudios para cada uno de los cinco conjuntos de datos. Nuestro análisis revela que los modelos híbridos, particularmente las arquitecturas CNN-LSTM, logran consistentemente una precisión superior en todos los puntos de referencia. Además, el optimizador Adam y los protocolos de validación leave-one-subject-out (LOSO) se identifican como las opciones más efectivas para la robustez. Concluimos identificando obstáculos clave, como el ruido de los sensores, la variabilidad entre sujetos y las limitaciones de procesamiento en tiempo real, y sugerimos direcciones de investigación futuras para mejorar la solidez, generalización y eficiencia de los sistemas HAR.
Abstract (EN)
Human activity recognition (HAR) using sensor data allows the automatic detection of human behavior and actions in everyday environments. The development of scalable and privacy-preserving HAR systems is supported by the nonintrusive collection of time-series data using wearable devices and smartphone sensors. Advances in deep learning have further improved recognition accuracy, expanding the applications of HAR across domains, including healthcare and human-computer interaction. Unlike existing surveys that primarily focus on architectural advancements, this study offers the first systematic review that places benchmark datasets at the forefront. This study provides a comprehensive examination of various deep models used in HAR, assessing their relative advantages, limitations, and optimization strategies based on an extensive review of 226 studies. It also delves into the core aspects of HAR system design, including data preprocessing, feature extraction, evaluation metrics, and validation approaches. Through a systematic examination of 160 studies, we analyzed HAR systems built using deep models in terms of architecture, performance, and implementation challenges on five widely adopted benchmark datasets (USC-HAD, PAMAP2, WISDM, UCI-HAR, and OPPORTUNITY). To ensure a balanced comparison across the benchmarks, we analyzed 32 studies for each of the five datasets. Our analysis reveals that hybrid models, particularly CNN-LSTM architectures, consistently achieve superior accuracy across benchmarks. Furthermore, the Adam optimizer and leave-one-subject-out (LOSO) validation protocols are identified as the most effective choices for robustness. We conclude by identifying key obstacles, such as sensor noise, intersubject variability, and real-time processing constraints, and suggest future research directions to improve the robustness, generalizability, and efficiency of HAR systems.
Walsh sequences as direct Error Correcting Output Code dichotomies for multiclass problems
Resumen (ES)
Resolver problemas de clasificación multiclase utilizando esquemas de Código de Salida de Corrección de Errores (ECOC) ofrece flexibilidad y robustez, pero los enfoques tradicionales basados en secuencias de Rademacher sufren un aumento exponencial de dicotomías con el número de clases. Este artículo presenta dos contribuciones principales. En primer lugar, proponemos el uso de secuencias de Walsh para construir directamente dicotomías ECOC, permitiendo abordar problemas multiclase con clases C usando únicamente clasificadores C − 1, mientras se mantienen altas distancias de Hamming por parejas entre códigos de clase (C∕2). En segundo lugar, presentamos un método basado en principios para estimar probabilidades de clase posterior a partir de los resultados de clasificadores discriminativos entrenados con divergencias de Bregman. Esto proporciona una alternativa a la decodificación de Hamming, mejora la estimación de confianza y evita la inversión de matrices debido a la ortogonalidad de los códigos de Walsh. Los resultados experimentales en cinco conjuntos de datos multiclase —incluyendo Fashion-MNIST, Reconocimiento de Letras y Vocales— demuestran mejoras consistentes en la precisión de la clasificación (por ejemplo, una reducción del 5% de error en el conjunto de datos de Letras) y en la eficiencia computacional respecto a métodos de referencia como OvR y ECOC-Rademacher. El rendimiento se evaluó utilizando matrices estándar de precisión y confusión, validando las ventajas de nuestro enfoque tanto en rendimiento predictivo como en escalabilidad.
Abstract (EN)
Solving multiclass classification problems using Error Correcting Output Code (ECOC) schemes offers flexibility and robustness, but traditional approaches based on Rademacher sequences suffer from an exponential increase in dichotomies with the number of classes. This paper introduces two main contributions. First, we propose the use of Walsh sequences for directly constructing ECOC dichotomies, enabling multiclass problems with C classes to be addressed using only C − 1 classifiers, while preserving high pairwise Hamming distances between class codes (C∕2). Second, we present a principled method to estimate posterior class probabilities from the outputs of discriminative classifiers trained with Bregman divergences. This provides an alternative to Hamming decoding, improves confidence estimation, and avoids matrix inversion due to the orthogonality of Walsh codes. Experimental results on five multiclass datasets—including Fashion-MNIST, Letter Recognition, and Vowel—demonstrate consistent improvements in classification accuracy (e.g., a 5% error reduction on the Letter dataset) and computational efficiency over baseline methods such as OvR and ECOC-Rademacher. Performance was evaluated using standard classification accuracy and confusion matrices, validating the advantages of our approach in both predictive performance and scalability.
Generative artificial intelligence for heart sound analysis: From model architectures to clinical applications
Resumen (ES)
La auscultación cardíaca implica escuchar los sonidos del corazón para diagnosticar afecciones cardíacas. La interpretación precisa de estos sonidos requiere una experiencia considerable, lo que limita la coherencia entre los médicos y entre entornos. Aunque el aprendizaje profundo ofrece un camino hacia la automatización, la escasez de datos, el desequilibrio de clases y la complejidad de las señales plantean desafíos para su aplicación al análisis de ruidos cardíacos. Este estudio presenta un examen exhaustivo pionero de cómo los modelos de inteligencia artificial generativa (IA generativa), incluidas las redes generativas adversarias, los autocodificadores variacionales, los modelos de difusión y las arquitecturas basadas en transformadores, pueden abordar desafíos clave en el análisis del sonido cardíaco. Específicamente, estos modelos mitigan las limitaciones centrales al sintetizar señales de sonido cardíaco de alta fidelidad para aumentar los datos, mejorar la calidad de la señal mediante la eliminación avanzada de ruido y permitir la detección semisupervisada y no supervisada de condiciones patológicas raras. Además, analizamos sus funciones en el aprendizaje avanzado de funciones y la traducción intermodal. A pesar de los notables avances, destacamos los desafíos futuros, entre ellos garantizar la fidelidad fisiológica, mejorar la interpretabilidad del modelo y validar la utilidad clínica. En conclusión, la IA generativa aborda un desafío traslacional clave al permitir una evaluación cardíaca experta accesible, precisa y escalable, apoyando así la implementación de la cardiología de precisión.
Abstract (EN)
Cardiac auscultation involves listening to heart sounds to diagnose cardiac conditions. Accurate interpretation of these sounds requires considerable experience, which limits consistency among clinicians and across settings. Although deep learning offers a path toward automation, data scarcity, class imbalance, and signal complexity pose challenges for its application to heart sound analysis. This study presents a pioneering comprehensive examination of how generative artificial intelligence (generative AI) models, including generative adversarial networks, variational autoencoders, diffusion models, and transformer-based architectures, can address key challenges in heart sound analysis. Specifically, these models mitigate core limitations by synthesizing high-fidelity heart sound signals for data augmentation, improving signal quality through advanced denoising, and enabling semi-supervised and unsupervised detection of rare pathological conditions. In addition, we discuss their roles in advanced feature learning and cross-modal translation. Despite notable progress, we highlight future challenges, including ensuring physiological fidelity, enhancing model interpretability, and validating clinical utility. In conclusion, generative AI addresses a key translational challenge by enabling accessible, accurate, and scalable expert cardiac evaluation, thereby supporting the implementation of precision cardiology.
Classification of systolic murmurs in heart sounds using multiresolution complex Gabor dictionary and vision transformer
Resumen (ES)
Los soplos sistólicos son ruidos cardíacos adicionales que ocurren durante la fase de contracción del ciclo cardíaco y que a menudo indican anomalías cardíacas causadas por un flujo sanguíneo turbulento. Su intensidad, tono y calidad varían, lo que requiere una identificación precisa para el diagnóstico preciso de los trastornos cardíacos. Este estudio presenta un sistema de clasificación automática de soplos sistólicos utilizando un módulo de extracción de características, seguido de un modelo de clasificación. El módulo de extracción de características emplea una búsqueda de coincidencia ortogonal compleja para proyectar segmentos de soplo únicos o múltiples en un diccionario redundante compuesto de funciones de base de Gabor (GBF) complejas de resolución múltiple. Los pesos de proyección resultantes se dividen y se transforman en matrices de características de tiempo–frecuencia de resolución variable. Procesar múltiples segmentos de una sola grabación utilizando un diccionario compartido mitiga la variabilidad del soplo. Esto se logra aprendiendo los pesos de cada segmento y al mismo tiempo garantizando que correspondan al mismo conjunto de funciones base en el diccionario, promoviendo matrices de características de tiempo–frecuencia consistentes. El modelo de clasificación se construye basándose en un transformador de visión para procesar múltiples matrices de entrada de diferentes resoluciones pasando cada una a través de una red neuronal convolucional para la tokenización de parches. Luego, todos los tokens de incrustación se concatenan para formar una matriz y se reenvían a una capa codificadora que incluye atención de múltiples cabezales, conexiones residuales y una red convolucional con un tamaño de núcleo de uno. Esta integración de la extracción de características multirresolución con la clasificación de características basada en transformadores mejora la precisión y confiabilidad de la identificación de soplos cardíacos. Un análisis experimental de cuatro tipos de soplos sistólicos del conjunto de datos CirCor DigiScope demuestra la eficacia del sistema, logrando una precisión de clasificación del 95,96%.
Abstract (EN)
Systolic murmurs are extra heart sounds that occur during the contraction phase of the cardiac cycle, often indicating heart abnormalities caused by turbulent blood flow. Their intensity, pitch, and quality vary, requiring precise identification for the accurate diagnosis of cardiac disorders. This study presents an automatic classification system for systolic murmurs using a feature extraction module, followed by a classification model. The feature extraction module employs complex orthogonal matching pursuit to project single or multiple murmur segments onto a redundant dictionary composed of multiresolution complex Gabor basis functions (GBFs). The resulting projection weights are split and reshaped into variable-resolution time–frequency feature matrices. Processing multiple segments of a single recording using a shared dictionary mitigates murmur variability. This is achieved by learning the weights for each segment while enforcing that they correspond to the same set of basis functions in the dictionary, promoting consistent time–frequency feature matrices. The classification model is built based on a vision transformer to process multiple input matrices of different resolutions by passing each through a convolutional neural network for patch tokenization. All embedding tokens are then concatenated to form a matrix and forwarded to an encoder layer that includes multihead attention, residual connections, and a convolutional network with a kernel size of one. This integration of multiresolution feature extraction with transformer-based feature classification enhances the accuracy and reliability of heart murmur identification. An experimental analysis of four types of systolic murmurs from the CirCor DigiScope dataset demonstrates the effectiveness of the system, achieving a classification accuracy of 95.96%.
2025
Application of natural language processing techniques to network traffic processing for classification using deep learning models
Resumen (ES)
Antecedentes El rápido crecimiento del tráfico de red cifrado ha aumentado la necesidad de una Clasificación de Tráfico de Red (NTC) efectiva y sin sesgos. Las técnicas tradicionales tienen dificultades con datos cifrados, disponibilidad limitada de características y alto volumen de tráfico, lo que reduce su fiabilidad en escenarios reales. Métodos Proponemos una metodología de preprocesamiento novedosa que analiza el tráfico de red en bruto y lo convierte en un formato textual (nt2txt), permitiendo la aplicación de técnicas de Procesamiento de Lenguaje Natural (NLP) y Aprendizaje Profundo. Este enfoque elimina el sesgo de los metadatos del protocolo, estructura los datos en semi-flujos de tamaño fijo y utiliza una división rigurosa de datos para evitar la superposición de flujos entre entrenamiento y prueba. Luego se entrena un modelo basado en LSTM para clasificar el tráfico usando únicamente los datos de la carga útil. Resultados Este trabajo ofrece un marco escalable y agnóstico al protocolo para la clasificación de tráfico cifrado, demostrando la efectividad de las técnicas de PLN en la mejora del rendimiento del modelo y la reducción del sesgo en los conjuntos de datos. Nuestra metodología alcanzó un 88,87 ± 0,04% de precisión en un conjunto de datos externo ciego, superando a modelos similares de LSTM y CNN-LSTM híbridos. Métricas como el Kappa de Cohen y el Coeficiente de Correlación de Matthew confirman además la solidez y la capacidad de generalización de nuestro enfoque.
Abstract (EN)
Background
The rapid growth of encrypted network traffic has increased the need for effective and unbiased Network Traffic Classification (NTC). Traditional techniques struggle with encrypted data, limited feature availability, and high traffic volume, reducing their reliability in real-world scenarios.
Methods
We propose a novel pre-processing methodology that analyzes raw network traffic into a textual format (nt2txt), enabling the application of Natural Language Processing (NLP) and Deep Learning techniques. This approach eliminates bias from protocol metadata, structures the data into fixed-size semi-flows, and uses rigorous data-splitting to prevent flow overlap between training and testing. An LSTM-based model is then trained to classify traffic using only payload data.
Results
This work provides a scalable, protocol-agnostic framework for encrypted traffic classification, demonstrating the effectiveness of NLP techniques in improving model performance and reducing dataset bias. Our methodology achieved 88,87 ± 0,04% accuracy on a blind external dataset, outperforming similar LSTM and hybrid CNN-LSTM models. Metrics such as Cohen’s Kappa and Matthew’s Correlation Coefficient further confirm the robustness and generalizability of our approach.
Multilevel neural networks with dual-stage feature fusion for human activity recognition
Resumen (ES)
El reconocimiento de actividad humana (HAR, por sus siglas en inglés) se refiere al proceso de identificar acciones y actividades humanas utilizando datos recogidos mediante sensores. Las redes neuronales, como las redes neuronales convolucionales (CNN), las redes de memoria a corto y largo plazo (LSTM), las redes convolucionales LSTM y sus combinaciones híbridas, han demostrado un rendimiento excepcional en diversos ámbitos de investigación. El desarrollo de un modelo multnivel ⚠️[REVISAR: errata, "multinivel"], individual o híbrido para HAR implica integrar estratégicamente múltiples redes con el fin de aprovechar sus fortalezas complementarias. La disposición estructural de estos componentes constituye un factor crítico que influye en el rendimiento global. En este estudio se exploró un marco novedoso basado en una arquitectura de red de dos niveles con fusión de características en dos etapas: una fusión tardía (late fusion), que combina las salidas del primer nivel de la red, y una fusión intermedia (intermediate fusion), que integra las características provenientes tanto del primer como del segundo nivel. Evaluamos diferentes arquitecturas de redes CNN, LSTM y convolucionales LSTM, incorporando fusión tardía con y sin fusión intermedia, con el objetivo de identificar la configuración óptima. La evaluación experimental realizada sobre dos conjuntos de datos públicos de referencia demostró que las arquitecturas que incluyen tanto fusión tardía como fusión intermedia alcanzan una mayor precisión que aquellas que dependen únicamente de la fusión tardía. Además, la configuración óptima superó a los modelos de referencia (baseline), validando así su eficacia para el reconocimiento de actividad humana.
Abstract (EN)
Human activity recognition (HAR) refers to the process of identifying human actions and activities using data collected from sensors. Neural networks, such as convolutional neural networks (CNNs), long short-term memory (LSTM) networks, convolutional LSTM, and their hybrid combinations, have demonstrated exceptional performance in various research domains. Developing a multilevel individual or hybrid model for HAR involves strategically integrating multiple networks to capitalize on their complementary strengths. The structural arrangement of these components is a critical factor influencing the overall performance. This study explored a novel framework of a two-level network architecture with dual-stage feature fusion: late fusion, which combines the outputs from the first network level, and intermediate fusion, which integrates the features from both the first and second levels. We evaluated ⚠️[REVISAR: doble espacio, parece que falta un número] different network architectures of CNNs, LSTMs, and convolutional LSTMs, incorporating late fusion with and without intermediate fusion, to identify the optimal configuration. Experimental evaluation on two public benchmark datasets demonstrated that architectures incorporating both late and intermediate fusion achieve higher accuracy than those relying on late fusion alone. Moreover, the optimal configuration outperformed baseline models, thereby validating its effectiveness for HAR.
A hybrid neural network with multistage feature fusion for detecting heart failure and murmurs from time–frequency representations of phonocardiograms
Resumen (ES)
La insuficiencia cardíaca produce sonidos anómalos y soplos debido al debilitamiento de la función cardíaca y al flujo sanguíneo turbulento. Este estudio presenta un modelo híbrido de red neuronal con fusión interna de características en múltiples etapas para detectar patologías cardíacas mediante el análisis tiempo–frecuencia de grabaciones de fonocardiogramas (PCG). El modelo combina redes neuronales convolucionales con capas de memoria a corto y largo plazo (LSTM) en una arquitectura única, con el fin de capturar de manera eficiente las dependencias espectro-temporales en múltiples etapas encadenadas de la red. Además, se emplea un mecanismo de fusión para agregar características internas de varias etapas y mejorar el modelado de patrones. Se investigaron diversas representaciones tiempo–frecuencia de señales PCG para extraer características relevantes para el entrenamiento y la evaluación del modelo. Estas representaciones se obtuvieron mediante análisis multirresolución (MRA) usando la transformada de Fourier de corta duración (STFT) o la transformada wavelet continua. Adicionalmente, se analizaron representaciones obtenidas a través de análisis multirresolución adaptativo (AMRA), empleando la transformada de Hilbert–Huang basada en descomposición en modos empíricos (EMD), descomposición variacional en modos (VMD) o transformada wavelet empírica (EWT). El rendimiento de clasificación del modelo se evaluó utilizando dos conjuntos de datos independientes, mostrando que la estrategia de fusión incrementa la precisión y que el MRA es superior al AMRA, alcanzando una exactitud del 90,20% en la detección de soplos cardíacos. En comparación con MRA, AMRA demostró una alta adaptabilidad, logrando una precisión del 99,30% al distinguir cinco condiciones valvulares cardíacas.
Abstract (EN)
Heart failure produces abnormal sounds and murmurs due to weakened cardiac function and turbulent blood flow. This study presents a hybrid neural network model with interior multistage feature fusion to detect heart pathologies using the time–frequency analysis of phonocardiogram (PCG) recordings. The model combines convolutional neural networks with long short-term memory layers in a unique architecture to efficiently capture the spectro-temporal dependencies at multiple cascaded network stages. Moreover, a fusion mechanism is used to aggregate internal features from multiple stages to enhance pattern modeling. We investigated various time–frequency representations of PCG signals to extract relevant features for model training and evaluation. These representations were derived using multiresolution analysis (MRA) via the short-time Fourier transform or the continuous wavelet transform. Additionally, we examined representations obtained through adaptive multiresolution analysis (AMRA) by employing the Hilbert–Huang transform based on empirical mode decomposition, variational mode decomposition, or empirical wavelet transform. The classification performance of the model was evaluated using two separate datasets, showing that the fusion strategy increases the accuracy and that MRA is superior to AMRA, achieving a classification accuracy of 90.20% for the detection of heart murmurs. Compared with MRA, AMRA demonstrated high adaptability, achieving an accuracy of 99.30% in distinguishing five heart valvular conditions.
A Hybrid Artificial Intelligence Framework for Melanoma Diagnosis Using Histopathological Images
Resumen (ES)
El cáncer sigue siendo uno de los mayores desafíos de salud a nivel mundial debido a sus altas tasas de mortalidad y al conocimiento todavía limitado sobre su progresión. El diagnóstico temprano es fundamental para mejorar los resultados en los pacientes, especialmente en el caso del cáncer de piel, donde una detección oportuna puede aumentar significativamente las tasas de recuperación. El análisis histopatológico es un método diagnóstico ampliamente utilizado, pero se trata de un proceso lento y altamente dependiente de la experiencia de especialistas altamente capacitados. Los avances recientes en Inteligencia Artificial han mostrado resultados prometedores en clasificación de imágenes, lo que resalta su potencial como herramienta de apoyo para el diagnóstico médico. En este estudio, exploramos la aplicación de modelos híbridos de Inteligencia Artificial para el diagnóstico de melanoma utilizando imágenes histopatológicas. El conjunto de datos empleado consistió en 506 imágenes histopatológicas, de las cuales se seleccionaron 313 imágenes depuradas tras un control de calidad y un proceso de preprocesamiento. Proponemos un marco de trabajo en dos etapas que utiliza un Autoencoder para la reducción de dimensionalidad y la extracción de características de las imágenes, seguido de un algoritmo de clasificación para distinguir entre melanoma y nevo, entrenado sobre los vectores de características extraídos del cuello de botella (bottleneck) del Autoencoder. Evaluamos Máquinas de Vectores de Soporte (SVM), Random Forest, Perceptrón Multicapa (MLP) y K-Nearest Neighbours (K-NN) como clasificadores. Entre ellos, las combinaciones de Autoencoder con K-Nearest Neighbours lograron el mejor rendimiento y tiempo de inferencia, alcanzando una precisión media de aproximadamente 97,95% en el conjunto de prueba y requiriendo 3,44 minutos por diagnóstico. Los resultados de comparación con la línea base fueron consistentes, demostrando una fuerte capacidad de generalización y superando al resto de modelos entre 2 y 13 puntos porcentuales.
Abstract (EN)
Cancer remains one of the most significant global health challenges due to its high mortality rates and the limited understanding of its progression. Early diagnosis is critical to improving patient outcomes, especially in skin cancer, where timely detection can significantly enhance recovery rates. Histopathological analysis is a widely used diagnostic method, but it is a time-consuming process that heavily depends on the expertise of highly trained specialists. Recent advances in Artificial Intelligence have shown promising results in image classification, highlighting its potential as a supportive tool for medical diagnosis. In this study, we explore the application of hybrid Artificial Intelligence models for melanoma diagnosis using histopathological images. The dataset used consisted of 506 histopathological images, from which 313 curated images were selected after quality control and preprocessing. We propose a two-step framework that employs an Autoencoder for dimensionality reduction and feature extraction of the images, followed by a classification algorithm to distinguish between melanoma and nevus, trained on the extracted feature vectors from the bottleneck of the Autoencoder. We evaluated Support Vector Machines, Random Forest, Multilayer Perceptron, and K-Nearest Neighbours as classifiers. Among these, the combinations of Autoencoder with K-Nearest Neighbours achieved the best performance and inference time, reaching an average accuracy of approximately 97.95% on the test set and requiring 3.44 min per diagnosis. The baseline comparison results were consistent, demonstrating strong generalisation and outperforming the other models by 2 to 13 percentage points.
Intelligent ROI-Based Vehicle Counting Framework for Automated Traffic Monitoring
Resumen (ES)
El conteo preciso de vehículos mediante videovigilancia es crucial para una gestión eficiente del tráfico. Sin embargo, lograr una alta precisión en el conteo garantizando al mismo tiempo eficiencia computacional sigue siendo un desafío. Para abordar este problema, proponemos un marco completamente automatizado de conteo de vehículos basado en vídeo, diseñado para optimizar tanto la eficiencia computacional como la precisión del conteo. Nuestro marco funciona en dos fases diferenciadas: estimación y predicción. En la fase de estimación, se determina automáticamente la región de interés (ROI) óptima mediante una combinación novedosa de tres modelos basados en puntuaciones de detección, puntuaciones de seguimiento (tracking) y densidad de vehículos. Este enfoque adaptativo garantiza la compatibilidad con cualquier método de detección y seguimiento, lo que incrementa la versatilidad del marco. En la fase de predicción, el conteo de vehículos se realiza de forma eficiente dentro de la ROI estimada. Evaluamos nuestro marco utilizando conjuntos de datos de referencia como UA-DETRAC, GRAM, CDnet 2014 y ATON. Los resultados demuestran una precisión excepcional, alcanzando la mayoría de los vídeos una alta exactitud ⚠️[REVISAR: aquí iría la misma cifra que falta en inglés], al mismo tiempo que se mejora la eficiencia computacional, permitiendo un procesamiento hasta cuatro veces más rápido en comparación con el análisis del fotograma completo. El marco propuesto supera a las técnicas existentes, especialmente en escenarios complejos con múltiples carreteras, demostrando robustez y una precisión superior. Estos avances lo convierten en una solución prometedora para la monitorización del tráfico en tiempo real.
Abstract (EN)
Accurate vehicle counting through video surveillance is crucial for efficient traffic management. However, achieving high counting accuracy while ensuring computational efficiency remains a challenge. To address this, we propose a fully automated, video-based vehicle counting framework designed to optimize both computational efficiency and counting accuracy. Our framework operates in two distinct phases: estimation and prediction. In the estimation phase, the optimal region of interest (ROI) is automatically determined using a novel combination of three models based on detection scores, tracking scores, and vehicle density. This adaptive approach ensures compatibility with any detection and tracking method, enhancing the framework’s versatility. In the prediction phase, vehicle counting is efficiently performed within the estimated ROI. We evaluated our framework on benchmark datasets like UA-DETRAC, GRAM, CDnet 2014, and ATON. Results demonstrate exceptional accuracy, with most videos achieving ⚠️[REVISAR: falta el número, probablemente un porcentaje] accuracy, while also enhancing computational efficiency–making processing up to four times faster than full-frame processing. The framework outperforms existing techniques, especially in complex multi-road scenarios, demonstrating robustness and superior accuracy. These advancements make it a promising solution for real-time traffic monitoring.
Deep learning based deconvolution methods: A systematic review
Resumen (ES)
En esta revisión sistemática examinamos el papel de la Inteligencia Artificial (IA) y el Aprendizaje Profundo (Deep Learning, DL) en el desarrollo de herramientas de deconvolución celular, con un enfoque especial en su aplicación al análisis de datos transcriptómicos procedentes de la secuenciación de ARN (RNA sequencing). Destacamos la importancia crítica de contar con perfiles de referencia de alta calidad para mejorar la precisión de los métodos de deconvolución analizados, lo cual es esencial para determinar las composiciones celulares en muestras biológicas complejas. Para garantizar la solidez de nuestro trabajo, hemos aplicado un riguroso proceso de selección siguiendo las directrices de Preferred Reporting Items for Systematic Reviews and Meta-Analysis (PRISMA). A través del proceso de revisión, hemos identificado varias lagunas clave en la investigación, subrayando la necesidad de metodologías estandarizadas y la mejora de la interpretabilidad de los modelos. En conjunto, presentamos una visión general completa y actualizada de las diferentes metodologías, conjuntos de datos y hallazgos asociados a herramientas de deconvolución impulsadas por DL, abriendo el camino para futuras investigaciones y resaltando el valor de la colaboración entre las ciencias computacionales y biológicas.
Abstract (EN)
Within this systematic review we examine the role of Artificial Intelligence (AI) and Deep Learning (DL) in the development of cellular deconvolution tools, with an special focus on their application to the analysis of transcriptomics data from RNA sequencing. We emphasize the critical importance of high–quality reference profiles for enhancing the accuracy of the discussed deconvolution methods, which is essential to determine cellular compositions in complex biological samples. To ensure the robustness of our work, we have applied a rigorous selection process following the Preferred Reporting Items for Systematic Reviews and Meta–Analysis (PRISMA) guidelines. Through the review process, we have identified several key research gaps, highlighting the necessity for standardized methodologies and the improvement of the interpretability of the models. Overall, we present a comprehensive, up to date overview of the different methodologies, datasets, and findings associated with DL–driven deconvolution tools, paving the way for future research and emphasizing the value of collaboration between computational and biological sciences ⚠️[REVISAR: falta el punto final; comprobar que no se cortó el texto]
2023
A systematic review of electroencephalography open datasets and its usage with deep learning models
Resumen (ES)
Un artículo titulado "A systematic review of electroencephalography open datasets and its usage with deep learning models" ha sido aceptado para su publicación por el IEEE Access Journal (Q2). Este artículo, del que son coautores Alberto Nogales Moyano y Alvaro José García Tejedor, recopila un conjunto de artículos de alta calidad sobre aprendizaje profundo y electroencefalografía y analiza los conjuntos de datos abiertos utilizados y disponibles de forma gratuita para la comunidad científica.
Abstract (EN)
A paper entitled: "A systematic review of electroencephalography open datasets and its usage with deep learning models" has been accepted for publication by the IEEE Access Journal (Q2). This paper co-authored by Alberto Nogales Moyano and Alvaro José García Tejedor compiles a set of high-quality papers in deep learning and electroencephalography and analyzes the used open datasets freely available for the scientific community.
A deep learning framework for audio restoration using Convolutional/Deconvolutional Deep Autoencoders
Resumen (ES)
Las personas se comunican a diario con sus teléfonos móviles y, en algunos casos, la calidad de la comunicación puede ser vital. Por lo tanto, hay un interés claro en mejorar la calidad de la comunicación en situaciones de señal baja o interferencias. Este artículo muestra cómo se utilizan técnicas de aprendizaje profundo para restaurar archivos de audio que simulan situaciones de ruido de fondo y pérdida de señal. Su característica principal es el uso directo de la onda sonora en lugar de una representación en espectrograma, lo que permite que el modelo se adapte a comunicaciones o transmisiones en tiempo real. Los resultados muestran que nuestra propuesta mejora el rendimiento en comparación con Wave-U-Net. Después de restaurar el audio, la diferencia entre el audio original y el restaurado es, en promedio, menor al 2%. Además, se realizó una prueba subjetiva con 113 personas, quienes detectaron una mejora significativa en el audio restaurado en comparación con el dañado.
Abstract (EN)
People communicate daily with their mobile phones and in some cases, the quality of the communication may be vital. Thus, there is a clear interest in improving the quality of communication in cases of low signal or interferences. This paper shows how deep learning techniques are used to restore audio files that simulate situations of background noise and loss of signal. Its main distinguishing feature is the direct use of the waveform instead of a spectrogram representation which lets the model be adapted to real-time communications or broadcasting. The results show that our proposal improves performance compared to Wave-U-Net. After restoring the audio, the difference between the original and the restored audio is, on average, less than 2%. In addition, a subjective test was carried out with 113 people who detected a significant improvement in the restored audio compared to the damaged one.